Tại sao mình chọn Astro + Content Collections cho blog cá nhân
Khi bắt tay vào xây thangdinh.dev, mình muốn một stack đủ nhẹ để build nhanh, nhưng vẫn đủ “đúng” để không phải viết lại sau vài tháng. Bài này ghi lại vài quyết định kỹ thuật cụ thể — không phải để quảng cáo Astro, mà để sau này đọc lại còn nhớ vì sao mình chọn vậy.
Static output, không SSR
Toàn bộ nội dung trên trang — bài viết, trang chủ, trang giới thiệu — đều biết trước tại thời điểm build. Không có dữ liệu cần fetch theo request, không có cá nhân hóa theo người dùng. Vậy thì SSR chỉ thêm độ phức tạp: cần một Node server chạy 24/7, cần adapter, cần lo chuyện scale. Astro build ra HTML tĩnh, mình serve bằng Caddy trong một container nhẹ, không cần Node runtime ở production. Giscus (bình luận) và Cloudflare Web Analytics là script phía client, không đụng gì đến chuyện render server.
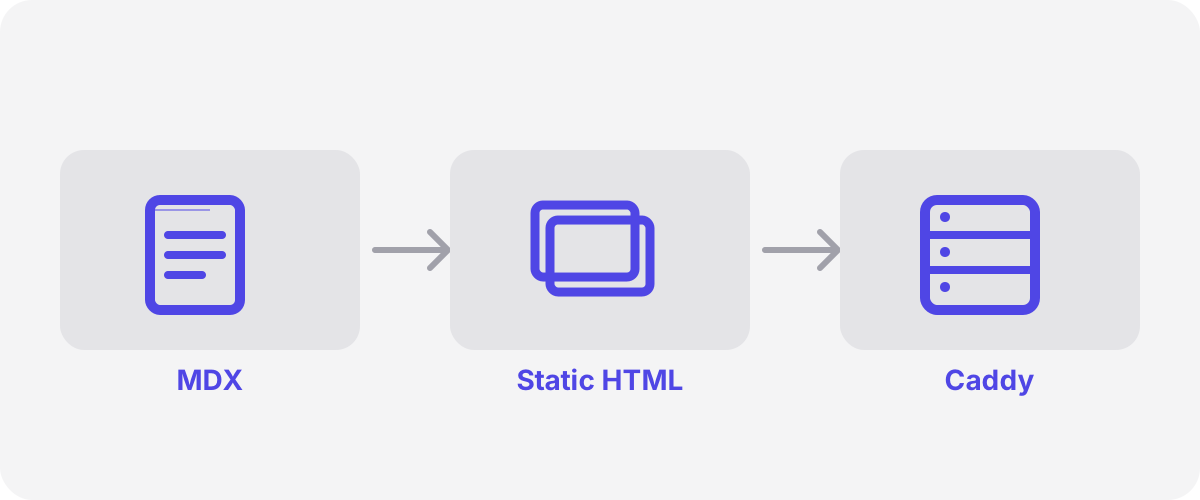
Nguyên tắc chung: chỉ thêm SSR khi có nhu cầu thật (auth, dữ liệu động theo user). Ở đây không có, nên giữ static.
Content Collections với glob() loader
Astro 5 trở lên có Content Layer API, thay cho cách khai báo collection cũ. Mình dùng loader glob() để quét toàn bộ file .mdx trong src/content/blog, mỗi file map thẳng sang một id (chính là tên file, không cần thư mục con theo pillar):
const blog = defineCollection({
  loader: glob({ pattern: '**/*.mdx', base: './src/content/blog' }),
  schema: z.object({
    title: z.string(),
    pillar: z.enum(['tech', 'ai', 'pm']),
    pubDate: z.coerce.date(),
    // ...
  }),
});
Điểm hay là schema được validate bằng Zod ngay lúc astro check/build — nếu mình quên field pillar hay gõ sai giá trị enum, build fail ngay, không phải chờ tới lúc lên production mới phát hiện trang archive bị thiếu bài.
Một chi tiết dễ bỏ sót: vì pillar là field trong frontmatter chứ không phải cấu trúc thư mục, route /blog/tech, /blog/ai, /blog/pm (trang archive theo pillar) và route bài viết /blog/[...slug] dùng chung namespace /blog/*. Nếu một bài viết nào đó có id trùng đúng tech, ai, hoặc pm, nó sẽ đụng route archive. Giải pháp đơn giản: chọn slug bài viết dài và mô tả rõ nội dung, không bao giờ trùng tên pillar. Chi tiết đầy đủ về glob() loader và schema nằm trong tài liệu Content Collections của Astro.
Tailwind v4: theme tokens thay cho file design-token riêng
Trước đây làm design system thường phải có riêng một file token (JSON hoặc TS) rồi map sang Tailwind config. Tailwind v4 gộp việc đó vào thẳng CSS bằng khối @theme:
@theme {
  --color-bg: #000000;
  --color-accent: #4F46E5;
  --font-sans: 'Geist', ui-sans-serif, system-ui, sans-serif;
}
Mỗi biến --color-* tự sinh ra utility class tương ứng (bg-accent, text-accent…), mỗi --font-* sinh font-sans. Không cần tailwind.config.js riêng, không cần lớp trung gian nào — palette của trang (nền đen tuyền, card #18181B, accent indigo) nằm gọn trong một file global.css. Các token theo theme sáng/tối tham chiếu lẫn nhau qua @theme inline, đúng như cách Tailwind khuyến nghị khi một theme variable cần tham chiếu một biến CSS khác.
Tự host font thay vì dùng Fontsource
Mình dùng Geist Sans/Mono nhưng không cài @fontsource/geist-sans — package đó chỉ ship subset latin, trong khi nội dung trang này hoàn toàn tiếng Việt có dấu. Thay vào đó mình lấy thẳng file .woff2 variable từ package geist chính chủ (node_modules/geist/dist/fonts/...) và tự khai báo @font-face. Cách này chắc chắn giữ được toàn bộ glyph, kể cả dấu tiếng Việt, mà không phụ thuộc vào việc một package trung gian có subset đúng ngôn ngữ mình cần hay không.
Ba quyết định trên đều nhỏ, nhưng cộng lại giúp trang chạy nhẹ, build nhanh, và ít chỗ để “một ngày nào đó phải viết lại”.